ベクトルDBのセットアップ、正直しんどくないですか。
ChromaやWeaviateを立てて、埋め込みモデルを選んで、チャンキング戦略を考えて……PoCのつもりが気づけばインフラ構築に時間を取られている、という経験がある人は多いと思います。
「ベクトルDBなしでRAGが動く」と謳うPageIndexというフレームワークが2025年9月にVectifyAIからリリースされ、GitHubのスターが2万3千を超えました(2026年3月末時点)。
「本当に?」と思いつつ社内PDFで試してみました。
PageIndexが埋め込みの代わりに何をしているかを概念レベルで整理したうえで、実際に動かすまでの手順と日本語ドキュメントへの適用実感を書きます。
「自分のユースケースに合うかどうか」を判断する材料になれば十分です。
埋め込みを捨てて何をしているのか——推論ベースインデックスの仕組み
通常のベクトルRAGは、ドキュメントを500トークン前後のチャンクに分割し、各チャンクを埋め込みベクトルに変換してDBに格納します。
クエリが来たら同じく埋め込んで、コサイン類似度の近いチャンクを引っ張ってくる——これが「距離で探す」という発想です。
PageIndexのアプローチは根本的に違います。
ひとことで言うと 構造を読んで推論で辿る です。
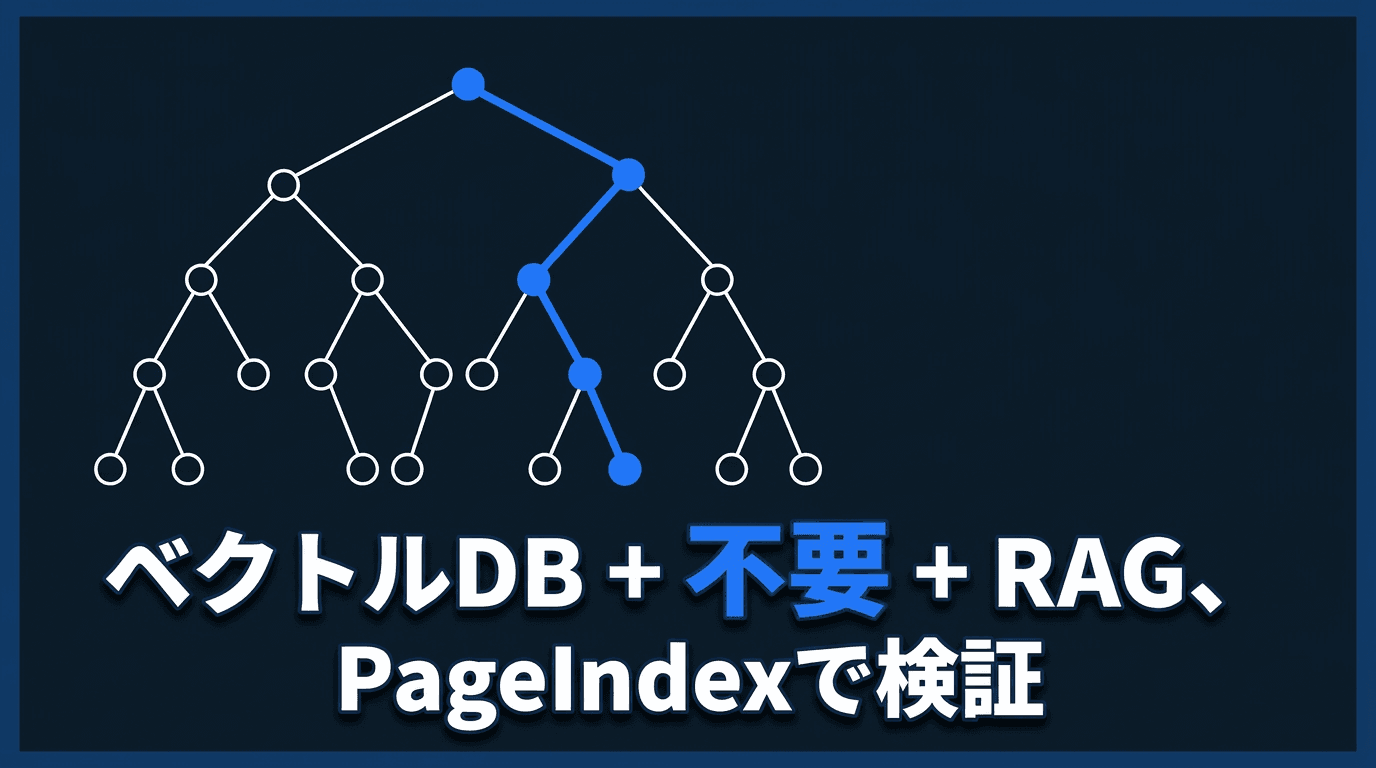
インスピレーションの源として公式が挙げているのがAlphaGoです。
AlphaGoは盤面のすべての手を全探索するのではなく、「次はここが有望」という判断で木探索を絞り込みました。
PageIndexも同じ発想で、ドキュメント全体を総ナメにするのではなく、構造を理解したうえで目的のノードに向かって推論しながら辿るという設計になっています。
具体的には、インデックス構築のタイミングでLLMがPDFの冒頭ページを読み、章・節・小節の階層構造をJSONのツリーとして組み立てます。
目次が明示されていない場合は見出しのパターンから推定します。
この段階で文書全体の「地図」が生成され、以降のクエリ処理はその地図を参照して動きます。
クエリが届くと、LLMはTOCツリー(タイトルとサマリだけで数百トークン程度の小さなデータ)を読んで、「この質問への答えがありそうなのはどのセクションか」を推論します。
ここがシステムのコアです。
コサイン距離ではなく、LLMの読解と判断が検索を担っています。
選ばれたノードのテキストを取り出してLLMに渡し、最終回答が生成される——ベクトルもチャンキングも登場しない流れです。
この構造の副産物として面白いのが、 検索の根拠がトレースできる 点です。
「どのセクションを選んで、なぜそこに向かったか」という推論の軌跡が残ります。
ベクトル検索だと「類似度が0.87だったから」という情報しか返らないので、なぜ選ばれたかを説明するのが難しい。
PageIndexはRetrievalResultオブジェクトに選択されたノードIDとソースセクション名が含まれていて、デバッグや説明責任の面でかなり助かります。
チャンキングが消えることの意味も大きいです。
500トークン窓でドキュメントを切ると、「前のチャンクの続きを読まないと意味が分からない」という状況が精度劣化の典型的な原因のひとつになります。
PageIndexは自然なセクション単位でドキュメントを扱うため、この問題が構造的に回避されます。
ゼロから動かす最小構成——インストールからPDFクエリまで
前提はPython環境とOpenAI APIキーがあること。それだけです。
pip install -U pageindex
export OPENAI_API_KEY="sk-..."
Cloudモードを使う場合はPageIndexのAPIキーも別途必要ですが、Localモードであれば不要です。
手軽に始めるならLocalモード一択です。
インデックス生成からクエリ実行までの最小構成は次のとおりです。
以下はVectifyAIの公式クイックスタートに準じた構成ですが、メソッド名・引数は執筆時点のものです。
最新のAPIは GitHubリポジトリ のREADMEで確認してください。
# 注意: 以下のAPIは執筆時点のものです。最新仕様はGitHub READMEで確認してください。
from pageindex import PageIndex

# インデックスを生成(初回はLLM推論が走るため数秒〜数十秒かかる)
pi = PageIndex("spec_document.pdf")
pi.build_index()

# クエリを実行
result = pi.query("第3章のシステム要件について教えてください")

print(result.answer)
print("参照セクション:", result.source_sections)
インデックスはローカルディレクトリに保存されるので、2回目以降はbuild_indexをスキップして読み込みだけでOKです。
LocalモードとCloudモードの使い分けは、次の基準で考えると整理しやすいです。
- テキストベースのPDFのみ扱う・データを外部に出したくない → Localモード(引用はページ単位)
- スキャンPDFや画像が混在する・ブロック単位の引用が必要 → Cloudモード
- フォルダ管理やMCPサーバー連携も使いたい → Cloudモード
スキャンPDF(OCRが必要なもの)はLocalモードでは対応していません。
古い社内文書がスキャンPDF中心の環境では、実質的にCloudモード一択になります。
日本語PDFについて補足しておくと、テキストベースのPDFであれば文字化けは基本的に起きません。
ただ、LLMが日本語テキストを読んでTOCツリーを作る際、英語と比べてトークン消費がやや多くなる傾向があります。
日本語はひとつの文字が複数トークンになりやすいためで、100ページ程度の仕様書なら体感できるほどの差ではありませんが、500ページを超えてくると積み重なります。
日本語ドキュメントで使ってみて気づいたこと
「日本語PDFを渡せばすんなり動く」というイメージで臨むと、ちょっと期待値のズレが生じます。
構造がはっきりした文書——章番号と見出しが明確な仕様書や年次報告書のような文書は、PageIndexの得意領域です。
TOCツリーを正確に構築しやすく、ノード選択の精度も上がります。
一方、議事録やメモ、社内チャットのログをPDF化したもののように、見出し構造が曖昧な文書は苦手です。
「第2節」「3.1」のような明確な階層がないと、ツリー自体があやふやになり、ルーティングの根拠も弱くなります。
よく引用される精度の数字について正直に書いておきます。
FinanceBenchというベンチマークで 98.7% という数字が出ています。
これは財務報告書を対象にした文書QA評価で、章立てが明確な構造化ドキュメントが対象です。
同ベンチマークで伝統的なベクトルRAGは約50%とされており、差は確かに大きい。
ただ、この数字を汎用的な精度の上限として受け取るのは少し楽観的すぎます。
財務報告書は「PageIndexにとって有利な条件が揃っている文書」の典型で、議事録やメモのような構造が薄い文書では同じ精度は期待できません。
数字の出所を理解したうえで「構造の良い文書なら高精度が期待できる」という読み方をするのが実態に近いです。
日本語固有の問題として、PDFの作り方によってテキスト抽出の品質がばらつく点もあります。
Wordで作ってPDF保存したものは概ね問題ありませんが、古い印刷物をスキャンしたもの、フォントが埋め込まれていないもの、縦書きレイアウトのものは、Localモードでは取り回しが難しくなります。
縦書き文書はそもそも多くのPDFパーサーで鬼門なので、PageIndex固有の話ではないですが、念のため。
コストの現実——LLM APIコール増加とベクトルDB運用費のトレードオフ
「ベクトルDBが不要になる」という話を聞くと、コストが下がるイメージを持ちやすいですが、現実はトレードオフです。
PageIndexでコストが増える理由はシンプルです。
インデックス構築時にLLMがドキュメントを読んでTOCツリーを生成するためAPIコールが発生し、さらにクエリ実行のたびにLLMがツリーを読んでルーティングを推論するため、毎回追加のAPIコールが走ります。
日本語テキストはトークン効率が英語より低いため、コストが上振れしやすい点も加わります。
一方でベクトルDB構成の場合、埋め込みモデルの呼び出しコスト自体はLLM推論より安価ですが、DBサーバーの運用費、チャンキング・インデックス更新のパイプライン維持、そのパイプラインを管理するエンジニアの工数が継続的にかかります。
「インフラなし」の魅力は、PoC段階ではこれらが丸ごと不要になる点で、そのインパクトはわりと大きいです。
「どちらが安いか」はドキュメント量とクエリ頻度次第で変わります。
判断の分岐点になる条件を整理しておくと、次のようになります。
- ドキュメントが数十〜百数十ページ規模でクエリ頻度が低め → PageIndexが有利
- ドキュメントが数千ファイルを超えてクエリが高頻度 → ベクトルDB構成のほうがコスト効率が良い
- PoCや検証フェーズ → セットアップコストの低さからPageIndexを試す価値がある
ドキュメント数が増え、クエリが高頻度に走るようなスケールになってくると、LLM推論コストが積み上がってベクトルDB構成より割高になる可能性があります。
「小規模で試して評価する」段階に最もフィットするツールだと捉えておくと、期待値のズレが少ないです。
向いているユースケース・向いていないユースケース、そして実務導入前の落とし穴
PageIndexが最もよく機能するのは、「構造が明確で規模が手頃なドキュメントを、精度重視でクエリする」シナリオです。
章番号と見出しがはっきりした製品仕様書や技術仕様書、年次報告書、法令・契約書・規程類のような文書が典型です。
更新頻度が低く、一度インデックスを作ったら長く使えるドキュメントであれば、さらに相性が良くなります。
レイテンシにある程度寛容な用途——バックオフィスの担当者が仕様を調べる、といったシナリオ——が現実的なスイートスポットです。
逆に向いていないケースもはっきりしています。
- 数千ファイルを横断する社内ナレッジベース全体の検索
- リアルタイムに近い応答が必要なチャットボット
- 頻繁に更新されるドキュメント(更新のたびに再インデックスとLLMコストが発生する)
- 見出し構造がほとんどない議事録・メモ・ログ系の文書
実務で導入する前に知っておきたい落とし穴として、まず 大量ドキュメント時のレイテンシ があります。
クエリのたびにLLM推論を挟む構造上、一定のレイテンシが避けられません。
横断検索の対象が増えるとTOCツリーのサイズも大きくなり、ルーティングの推論に時間がかかります。
「ユーザーが待てる秒数」と照らし合わせて、事前にベンチマークを取っておくのが無難です。
もうひとつは コンテキスト長の壁 です。
ノードを選択したあと、そのセクションのテキストをLLMに渡す際、セクションが長すぎると一度に扱えるトークン数を超えます。
チャンキングを使わないPageIndexの構造上、「第2章全体」のような大きな単位のセクションが選ばれるとこの問題が露出しやすいです。
ドキュメントの設計次第で回避できる部分もありますが、ドキュメントの構造をこちらが制御できない場合は素直に発生します。
「チャンキングが不要」という設計の裏側に、「セクションの粒度に依存する」という別の制約が潜んでいる——そこだけ頭に置いておくと、想定外の文書が来たときに慌てずに済みます。
これらを踏まえたうえで、「試す価値がある」というのは本音です。
ベクトルDBのセットアップに時間を使う前に、社内の構造化ドキュメントを対象にPageIndexで動くものを作ってみるというPoC戦略は筋が良いと思います。
ただし、スケールアウトを前提に設計するなら最初からその前提を置いておかないと、後で作り直しになります。
個人的な印象として、PageIndexは「インフラを立てる前に仮説を検証したい」フェーズのツールとして、かなり誠実に設計されています。
チャンキングとベクトルDBという2つの複雑さを取り除いた代わりに、「構造化ドキュメント」と「LLMコスト」という別の制約を引き受ける——そのトレードオフを理解した状態で使えば、PoC段階の生産性は確実に上がります。
株式会社ホコサキは山口県宇部を拠点に、Web制作・業務システム開発・AI活用支援を手がけています。
RAGのPoC構築や社内ドキュメント検索の設計について、構想段階からご相談いただけます。
お問い合わせはこちらからどうぞ。